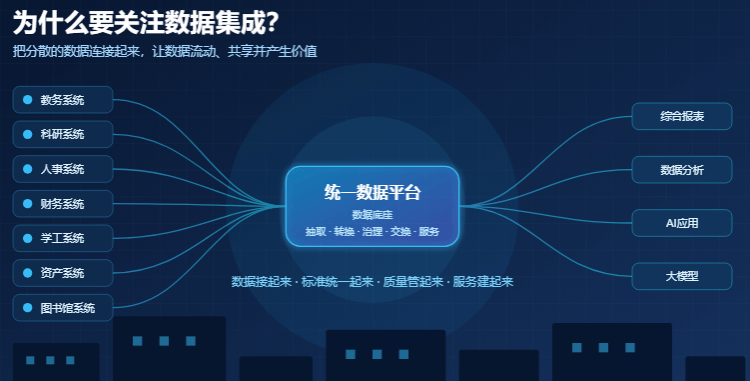
为什么要关注数据集成?
教务、科研、人事、财务、学工、资产、图书馆……高校在信息化建设过程中上线了大量业务系统,但也暴露出一系列共性问题:
这些问题的背后,都指向同一个原因:数据没有真正连接起来。
数据集成,就是把分散的数据连接起来,让数据能够流动、共享和产生价值。它不是简单的数据搬运,而是涵盖数据抽取、转换、治理、交换、服务的一整套技术体系,目标是让数据统一管理、跨部门共享、质量可靠、服务业务、支撑AI应用。
从趋势看,高校数据集成正从“数据搬运”走向“数据治理+数据服务+AI数据底座”。
第一部分:数据集成基础概念(1—15)
这一部分解决最基础的问题:高校为什么要做数据集成,以及数据集成到底在解决什么。
1. 数据集成(Data Integration)
将不同系统、数据库和数据源中的数据进行汇聚、转换和统一管理,使数据能够跨系统共享和使用。例如,将教务、学工、人事、科研、财务等系统的数据汇聚到统一数据平台。其核心价值是:打破系统之间的数据隔离。
2. 数据孤岛(Data Island)
数据分散在不同系统中,系统之间缺乏有效连接和共享。教务系统掌握成绩、学工系统掌握奖助、就业系统掌握毕业去向,如果这些数据无法关联,就难以形成完整的学生数据视图。数据孤岛是高校信息化从“系统建设”走向“数据赋能”后首先需要解决的问题。
3. 数据共享(Data Sharing)
不同部门和系统在权限范围内共同使用数据,核心是“一次采集,多方使用”。例如新生基本信息完成一次采集后,可按需提供给学籍、宿舍、财务、图书等系统使用。数据共享不意味着随意使用,而是在统一标准和权限控制下有序共享。
4. 数据流通(Data Circulation)
数据在不同系统、平台和应用之间传递和使用的过程。数据只有真正流动起来,才能从“存储资源”转化为可共享、可分析、可应用的数据资源。
5. 数据资产(Data Asset)
经过清洗、标准化、分类管理等加工治理后,能够产生业务价值的数据资源。从数据资源到数据资产,中间往往需要持续的数据治理。
6. 数据资源(Data Resource)
高校在教学、科研和管理过程中形成和积累的数据集合,包括学生、教师、教学、科研、财务及校园运行数据等。数据资源是基础,经过治理和管理后才能形成数据资产。
7. 数据底座(Data Foundation)
支撑高校数字化应用的数据基础设施和能力体系,包括数据平台、数据存储、数据治理和数据服务等能力。如果把智慧校园比作一栋建筑,数据底座就是它的数据“地基”。
8. 数据平台(Data Platform)
承载数据采集、存储、治理、分析和服务的技术平台。向下连接业务系统汇聚数据,向上为报表、分析平台和AI应用提供数据能力。
9. 数据中台(Data Middle Platform)
将分散数据进行统一汇聚、治理并形成共享服务的数据能力体系。重点不只是“把数据集中起来”,而是将共性数据能力沉淀下来,形成可重复调用的数据服务。
10. 数据服务(Data Service)
将治理后的数据封装为标准化能力,供业务系统和应用按权限调用,解决“数据治理好了以后,怎么更规范地提供给别人使用”的问题。
11. 数据生命周期(Data Lifecycle)
数据从产生到退出使用的全过程:产生→采集→存储→使用→归档→销毁。不同阶段对应不同的管理要求。
12. 数据架构(Data Architecture)
对学校数据如何组织、存储、流动和使用进行的整体设计,涉及数据模型、数据存储、数据标准、数据集成和数据服务等。如果说数据平台是技术设施,数据架构就是整个数据体系的“设计图”。
13. 数据体系(Data System)
高校围绕数据建设形成的一整套能力组合,既包括技术体系,也包括数据标准、管理制度和责任机制。做好数据工作,不是简单采购一套平台,而是技术、管理和机制共同建设。
14. 数据驱动决策(Data-driven Decision Making)
利用数据分析为管理和决策提供依据,从依靠经验判断转向“经验+数据”共同支撑。数据并不替代管理者决策,而是让决策拥有更充分的事实依据。
15. 数据价值化(Data Valorization)
通过治理、分析和应用,让数据真正产生业务价值。数据建设的最终目的不是“把数据存起来”,而是让数据真正进入业务、解决问题。
第二部分:数据架构与数据平台(16—30)
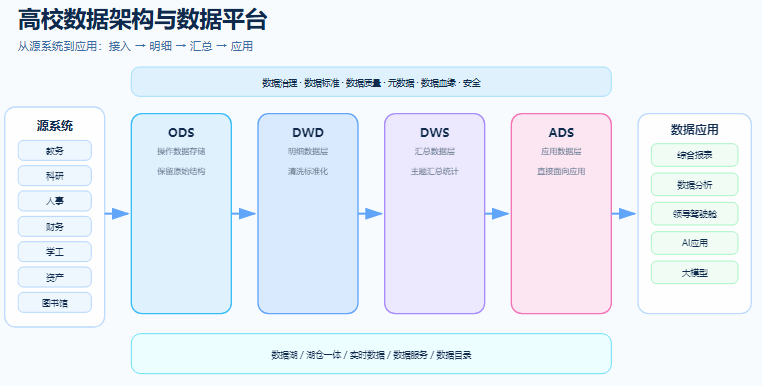
数据从各业务系统汇聚后,接下来要解决:放在哪里?按什么结构组织?经过哪些层次加工?最终怎么提供给业务使用?
16. 数据仓库(Data Warehouse)
面向数据分析和决策支持的数据存储体系,主要保存经过整理和加工的历史业务数据。高校常用于年度统计、教学分析、科研分析、领导驾驶舱等场景。
17. 数据湖(Data Lake)
能够集中存储大量原始数据的数据架构,可以先保存原始数据再按需加工,除结构化数据外还可存储日志、文件、图片等多种类型数据。
18. 湖仓一体(Lakehouse)
融合数据湖和数据仓库能力,既保留海量多类型数据的存储能力,又具备较强的数据管理和分析能力,是大数据和AI数据平台建设的重要方向。
19. 数据集市(Data Mart)
面向特定业务领域的小型、专题化数据集合,如教学数据集市、科研数据集市。如果把数据仓库看成一个综合仓库,数据集市就是按主题划分的“专区”。
20. 操作数据存储(ODS)
业务数据进入数据平台后的重要存储层,尽量保留源系统数据的原始结构和内容,是业务系统与数据仓库之间的重要衔接层。
21. 明细数据层(DWD)
保存经过清洗、标准化处理后的明细业务数据。与ODS相比,DWD中的数据已经过进一步治理和加工。
22. 汇总数据层(DWS)
在明细数据基础上进行主题汇总和统计加工形成的数据层。简单来说:DWD主要看明细,DWS主要做汇总。
23. 应用数据层(ADS)
直接面向具体数据应用的数据层。常见的数据仓库加工链路为:ODS→DWD→DWS→ADS,即接入原始数据→形成标准明细→进行汇总加工→提供应用使用。
24. 数据模型(Data Model)
描述数据结构以及不同数据对象之间的关系。学生、课程、教师、成绩并不是彼此独立的,将这些对象及其关系组织起来,就是数据模型要解决的问题。
25. 维度模型(Dimensional Model)
常用于数据仓库和数据分析的建模方式,由事实和维度组成。例如分析学生成绩:“成绩”是需要分析的事实,学院、专业、年级、课程、学期等则是分析维度。
26. 数据分层(Data Layering)
按数据来源、加工程度和使用目的,将数据划分为不同层次管理,让原始数据、明细数据、汇总数据和应用数据各司其职,提高开发、维护和问题排查效率。
27. 数据目录(Data Catalog)
对学校数据资源进行统一登记和描述的“数据地图”,回答学校有哪些数据、在哪里、什么意思、由谁负责、如何申请使用等问题。有了它,找数据不再完全依赖“找人问”。
28. 数据资产目录(Data Asset Catalog)
在数据目录基础上,对可管理、可使用的数据资产进一步登记和组织,关注数据负责人、质量、使用范围、权限和价值等信息。
29. 数据服务层(Data Service Layer)
位于底层数据与上层应用之间,通过标准接口向各系统提供数据,减少业务系统直接访问底层数据库带来的安全和管理问题。
30. 数据中台架构(Data Middle Platform Architecture)
围绕数据汇聚、存储、治理、服务和应用形成的整体技术架构,核心逻辑为:数据采集→数据存储→数据治理→数据服务→数据应用。目标不是再建一个“大数据库”,而是为不同业务提供可复用的数据支撑。
第三部分:数据治理体系(31—45)
数据汇聚到一起,并不意味着数据就能直接使用。数据治理要解决的,是数据“准不准、全不全、一不一致、能不能用”的问题。
31. 数据治理(Data Governance)
通过制度、流程、标准和技术手段,对数据进行持续、统一管理,使数据有人管、有标准、有质量、可使用,是数据共享、数据分析和数据资产化的基础。
32. 元数据(Metadata)
“描述数据的数据”,用于说明数据是什么、在哪里、从哪里来、由谁维护以及如何使用,解决“学校有哪些数据、这些数据是什么意思”的核心问题。
33. 技术元数据(Technical Metadata)
描述数据的技术属性,主要面向技术人员,包括数据库类型、表结构、字段类型、存储位置和更新时间等。
34. 业务元数据(Business Metadata)
描述数据的业务含义,帮助业务人员理解和使用数据。例如说明GPA代表“学生平均成绩绩点”及其具体计算口径。
35. 操作元数据(Operational Metadata)
记录数据在运行和处理过程中的信息,包括任务执行时间、同步状态、处理数量和运行日志等。
36. 数据标准(Data Standard)
统一数据的定义、编码、格式和使用规则,解决“同一个对象,不同系统有不同叫法、不同口径”的问题。例如统一“计算机学院”“计科院”等不同表述。
37. 数据标准管理(Data Standard Management)
对数据标准进行制定、发布、执行和维护的全过程管理,包括编码标准、命名标准、数据格式标准和指标标准。
38. 数据质量(Data Quality)
衡量数据是否准确、完整、一致、及时和唯一,是判断数据能否真正使用的重要基础。
39. 数据质量规则(Data Quality Rule)
检查和判断数据问题的具体标准,如学号不能为空、考试成绩应在规定范围内、教师工号必须唯一等,可通过治理平台自动执行。
40. 数据清洗(Data Cleansing)
识别并处理错误、重复、缺失和不规范数据的过程,包括去重、格式修正、缺失值处理、异常值处理和编码统一等。
41. 数据剖析(Data Profiling)
对数据内容、结构和分布进行分析,发现潜在数据质量问题。数据剖析侧重“发现问题”,数据清洗侧重“处理问题”。
42. 数据血缘(Data Lineage)
描述数据从哪里来、经过哪些处理、最终流向哪里。建立血缘后,一旦报表数据异常,可沿数据链路快速追溯。
43. 数据影响分析(Impact Analysis)
判断某项数据或结构变化后会影响哪些系统、接口、任务和应用。数据血缘解决“数据从哪来、到哪去”,影响分析解决“这里一改,会影响谁”。
44. 主数据管理(MDM)
对学生、教师、组织机构、专业、课程等核心基础数据进行统一管理,目标是:一个对象、一个标准、一个可信版本。
45. 数据资产管理(Data Asset Management)
将数据作为学校重要资源进行系统化管理,明确有哪些数据、谁负责、质量如何、谁能使用以及如何产生价值。
第四部分:ETL与数据开发技术(46—65)
数据治理解决“数据怎么管好”,ETL和数据开发解决“数据怎么进来、怎么加工、怎么送出去”。
46. ETL(Extract-Transform-Load)
抽取、转换、加载,是传统数据集成最常见的技术模式。典型流程:业务系统→数据抽取→数据转换→数据加载→数据仓库。
47. ELT(Extract-Load-Transform)
与ETL的最大区别在于处理顺序:先加载,再转换。更适合大数据平台、云数据平台和湖仓一体架构。
48. 数据抽取(Data Extraction)
从源系统获取数据的过程,数据来源可以是数据库、API接口、Excel/CSV文件、日志和消息流。
49. 数据转换(Data Transformation)
按统一标准和业务规则对原始数据加工,包括字段映射、格式转换、编码统一、数据计算、关联和清洗等。
50. 数据加载(Data Loading)
将处理后的数据写入目标系统,目标可以是数据仓库、数据湖、数据中台或其他业务数据库。
51. ETL任务(ETL Job)
一次完整的数据处理任务,可能包含读取源数据库、过滤新增数据、转换字段、执行质量校验并写入目标等多个步骤。
52. ETL调度(ETL Scheduling)
控制数据任务什么时候执行、按照什么顺序执行,让大量数据任务按照既定规则自动运行。
53. 数据工作流(Data Workflow)
描述多个数据任务之间的执行关系和依赖关系。例如生成教师画像前,需先完成基本信息、职称、科研项目等数据的同步。
54. 数据映射(Data Mapping)
建立不同系统之间字段和数据关系的过程,是异构系统数据集成中的基础工作。
55. 字段转换(Field Transformation)
按目标系统要求,对字段内容、类型或格式进行转换,如日期格式统一、编码转换等。
56. 数据关联(Data Join)
根据共同字段将不同数据表连接起来,是跨业务数据分析的基础操作。
57. 数据去重(Data Deduplication)
识别并处理重复数据。关键不是简单“删除重复项”,而是准确识别哪些记录实际属于同一个对象。
58. 数据校验(Data Validation)
检查数据是否符合既定规则和业务要求,校验不通过的数据通常需进入异常处理流程。
59. 数据增量抽取(Incremental Extraction)
只获取新增或发生变化的数据。相比全量抽取,速度更快、资源消耗更低,适合日常数据同步。
60. 全量抽取(Full Extraction)
每次读取源系统全部数据,逻辑简单但资源消耗大,通常用于首次数据迁移和数据初始化。
61. 数据回溯(Data Backfill)
对缺失或未正确处理的历史数据进行重新补充和计算,解决“历史数据缺了怎么办”的问题。
62. 数据管道(Data Pipeline)
连接数据产生、采集、处理、存储和使用全过程的自动化数据链路,可理解为数据从源系统到最终应用的“运输线路”。
63. 数据开发平台(Data Development Platform)
为数据工程人员提供统一开发环境,包括任务开发、SQL开发、代码管理、测试、发布和运行监控等能力。
64. 数据编排(Data Orchestration)
组织和协调多个数据任务之间的依赖和执行关系,重点解决“任务之间怎么配合”。
65. 数据任务管理(Data Task Management)
对数据任务从创建到运行维护的全过程管理,包括开发、测试、发布、执行、监控、告警和下线。
第五部分:实时数据与同步技术(66—80)
随着智慧校园、物联网和实时分析应用增多,很多数据已经不能等到第二天再更新。实时数据技术解决的是:数据发生变化后,如何更快地被发现、处理和使用。
66. CDC(Change Data Capture,变化数据捕获)
捕获数据库变化的技术,能识别数据的新增、修改和删除并同步到下游系统。相比全量同步,CDC只关注变化的数据,更适合实时或准实时集成。
67. 实时数据集成(Real-time Data Integration)
数据产生或变化后快速传输、处理并同步到目标系统,将同步周期缩短到秒级或分钟级。典型场景包括校园运行监控、物联网采集和实时数据大屏。
68. 批处理(Batch Processing)
按固定周期集中处理一批数据,技术成熟、运行稳定。成绩汇总、年度统计等大量高校管理业务仍适合采用批处理。
69. 微批处理(Micro Batch)
介于批处理和实时处理之间,每隔几分钟甚至几十秒处理一小批数据,在实时性和系统复杂度之间取得平衡。
70. 流式计算(Stream Computing)
对持续产生的数据进行连续处理,数据一边产生,系统一边计算,强调持续处理和低延迟。
71. 流批一体(Unified Batch and Streaming Processing)
用统一的技术体系处理历史批量数据和实时流数据,减少两套体系之间的重复建设和维护成本。
72. 消息队列(Message Queue)
系统之间传递消息和数据的中间机制,可降低系统耦合,提高数据传输稳定性。
73. Kafka
分布式事件流平台,具有高吞吐、可扩展和持久化等特点,可用于承接校园物联网、系统日志、业务事件等持续产生的数据。
74. Flink
分布式数据处理引擎,尤其擅长流式数据处理,可对持续进入的数据进行实时计算、状态管理和窗口统计。
75. Spark Streaming
Spark生态中的流数据处理技术,可与Spark大数据处理能力结合,用于日志分析、行为分析等场景。
76. 事件驱动架构(EDA)
以“事件”为核心触发业务处理的系统架构。例如“学生毕业”事件可自动触发账号调整、档案归档、校友系统更新等动作,适合多系统协同和实时业务联动。
77. 实时数仓(Real-time Data Warehouse)
在传统数仓基础上增强实时接入和计算能力,使数据以秒级或分钟级更新,支撑校园运行监控等高时效场景。
78. 实时数据湖(Real-time Data Lake)
在数据湖基础上支持实时数据持续写入和处理,传感器数据、系统日志、业务事件可不断进入并用于分析和AI应用。
79. 数据延迟(Data Latency)
数据产生到最终可被使用之间的时间差,是衡量数据集成和实时处理能力的重要指标。
80. 数据同步机制(Data Synchronization Mechanism)
保证不同系统间数据及时更新并保持一致的方法,包括全量同步、增量同步、定时同步和CDC同步。实际建设中需根据数据规模和业务要求选择合适机制。
第六部分:数据交换与系统集成技术(81—95)
高校往往同时运行大量业务系统,数据交换与系统集成技术负责建立这些系统之间的连接通道。
81. 数据交换平台(Data Exchange Platform)
统一管理不同系统间的数据交换和共享,具备数据发布、订阅、接口管理、权限控制和交换监控等能力。
82. API接口(API)
应用程序之间进行数据和功能调用的接口,已成为当前系统集成和数据服务最常见的方式之一。
83. API网关(API Gateway)
统一管理API的入口,负责身份认证、访问控制、流量限制、路由转发和运行监控。API负责提供服务,API网关负责管好这些API。
84. REST API
常见的网络接口设计方式,结构清晰、使用灵活、易于集成,广泛用于移动校园、微信服务、门户等应用。
85. Web Service
较传统的系统间通信技术,高校很多早期建设的教务、人事、财务系统仍保留此类接口。
86. SOAP协议
基于XML的消息交换协议,规范较严格,在早期大型管理系统中仍有较多应用。
87. ESB企业服务总线(Enterprise Service Bus)
集中式系统集成架构,通过统一“服务总线”完成服务调用、协议转换和消息传递,曾是高校系统集成平台的常见架构。
88. 消息中间件(Message Middleware)
负责系统间消息传递的软件基础设施,如Kafka、RabbitMQ、RocketMQ,可实现异步通信、削峰和系统解耦。
89. JDBC
Java访问数据库的标准接口,Java程序及很多ETL工具可通过它连接和读写各类数据库。
90. ODBC
开放的数据库访问标准,为不同应用访问不同数据库提供统一接口,不局限于Java生态。
91. 数据接口管理(API Management)
对接口从创建、发布到运行、监控和下线的全过程管理,避免接口重复建设、权限失控、无人维护等问题。
92. 数据交换标准(Data Exchange Standard)
规定系统间交换数据需遵循的规则,包括字段名称、数据格式、编码方式、接口规范等。没有统一标准,可能出现“接口通了,但数据含义对不上”的问题。
93. 文件交换(File Exchange)
通过Excel、CSV、XML等文件传输数据,简单、成本低,适合一次性迁移或低频交换,但不适合大数据量和实时性要求高的场景。
94. 数据订阅(Data Subscription)
业务系统按需订阅特定数据或数据变化,相比“每个系统主动去查”,订阅模式更适合持续的数据分发。
95. 数据服务接口(Data Service API)
将治理后的数据封装成标准API供其他系统调用,是将“数据资源”转化为“可复用数据能力”的重要方式。
第七部分:数据集成工具与平台(96—110)
高校建设数据集成平台通常有几种路线:开源工具自主建设、采购商业数据平台,或按国产化和信创要求选择国产平台。工具不同,但核心能力大体相似:连接数据源、同步数据、转换数据、调度任务、监控运行。
96. Kettle(Pentaho Data Integration)
经典ETL工具,支持可视化完成数据抽取、转换和加载,上手简单,在高校数据中心建设中应用较多。
97. DataX
阿里开源的离线数据同步工具,支持MySQL、Oracle、SQL Server、Hive、HDFS等多种数据源,适合多数据库、周期性批量同步场景。
98. Apache NiFi
面向数据流的数据集成工具,可视化设计数据采集、路由、转换和传输流程,适合日志采集和物联网数据接入。
99. Apache Hop
开源的数据集成和编排平台,支持数据转换、工作流和元数据管理,可用于数据仓库和数据集成任务建设。
100. Sqoop
用于关系型数据库与Hadoop生态之间批量传输数据的工具,代表早期大数据平台建设中的数据迁移方式。
101. Flume
面向日志数据采集的工具,主要用于将大量持续产生的日志汇聚到大数据平台。
102. Informatica PowerCenter
企业级数据集成平台,企业级功能和治理体系较完善,适合数据源复杂、规模较大的组织。
103. IBM DataStage
企业级ETL和数据集成工具,主要面向大型组织和复杂企业级数据集成场景。
104. Talend
覆盖数据集成、数据质量、API以及云数据处理的产品体系,数据连接能力较丰富。
105. ETLCloud
谷云2018年推出的国产数据集成平台,提供数据采集、转换、同步、任务调度和管理等能力,可用于信创异构数据源连接、ETL开发和数据平台建设,支持多中心架构。
106. FineDataLink
帆软2022年推出的国产数据集成平台,提供数据同步、ETL、数据开发和数据服务等能力,强调集成任务的统一开发、调度、运维和管理。
107. DataWorks
阿里云的数据开发与治理平台,覆盖数据集成、开发、调度、治理和运维等能力,接近一套云上数据开发和治理工作平台。
108. DataArts Studio
华为云的数据治理和开发平台,覆盖数据集成、开发、架构、质量和服务等能力,适用于云上数据平台及国产化技术体系场景。
109. AWS Glue
AWS的云原生数据集成服务,用户无需自行维护ETL服务器,适合已使用AWS云环境的场景。
110. Apache DolphinScheduler
开源的分布式工作流任务调度平台,负责任务依赖、定时执行、失败重试和运行监控,在数据平台中常承担“任务调度中心”角色。
第八部分:数据安全与AI时代的数据基础能力(111—130)
数据汇聚越多,安全问题越重要;AI应用越深入,对数据质量的要求也越高。这是高校数据建设从“数据集成”走向“AI数据底座”的关键一步。
111. 数据安全治理(Data Security Governance)
通过制度、流程和技术手段,对数据采集、存储、使用、共享和销毁等环节进行安全管理。数据治理解决“数据好不好用”,数据安全治理解决“数据能不能安全地用”。
112. 数据分类分级(Data Classification and Grading)
按数据的业务属性、重要程度和敏感程度进行分类并确定保护级别,让不同类型、不同敏感程度的数据采取不同的保护措施。
113. 数据脱敏(Data Masking)
对敏感信息进行遮蔽、替换或变形,在保留数据使用价值的同时降低泄露风险,常用于数据共享、测试环境、科研分析和报表展示。
114. 数据加密(Data Encryption)
通过密码技术保护数据,通常包括传输加密和存储加密两类。
115. 数据权限管理(Access Control)
解决“谁可以看什么数据、可以进行什么操作”。权限需要细化到数据、字段甚至具体操作,而不能只做到“能不能登录”。
116. 数据审计(Data Audit)
对数据访问和操作行为进行记录和追踪:谁访问了数据、什么时候、访问了哪些、进行了什么操作。审计日志是问题追溯的重要依据。
117. 等级保护2.0(MLPS 2.0)
我国网络安全等级保护制度体系的重要组成部分,高校在建设业务系统和数据平台时需按重要程度落实相应安全保护要求。
118. 个人信息保护(Personal Information Protection)
按相关法律法规对能够识别特定个人的信息进行规范处理和保护。高校数据采集、使用、共享和对外提供,都需明确使用目的、权限和保护措施。
119. 数据安全生命周期(Data Security Lifecycle)
将安全要求贯穿数据从产生到销毁的全过程:采集安全→传输安全→存储安全→使用安全→共享安全→归档与销毁安全。
120. 零信任安全(Zero Trust Security)
以“持续验证”为核心的安全理念,不因用户已进入校园网或完成过一次登录就默认可信,而是根据身份、设备、权限和访问环境持续验证。
迈向AI数据底座
进入大模型时代,AI面对的不只是结构化数据,还包括规章制度、教学资料、科研文献、图片、音视频等大量非结构化数据。高校的数据基础能力,正从“让业务系统能够使用数据”走向“让AI能够理解和使用数据”。
121. AI-ready数据
经过治理后,能够直接或经过较少处理就用于AI训练、检索、推理和应用的数据。过去数据治理考虑“人能不能看懂、系统能不能调用”,AI-ready进一步考虑“机器能不能理解、模型能不能使用”。
122. 大模型数据底座(LLM Data Foundation)
支撑高校大模型应用的数据基础能力集合,既包括业务数据库和数据仓库,也包括规章制度、教学资源、知识库、向量数据及相应服务能力。大模型能否真正落地,很大程度上取决于背后的数据底座。
123. RAG(检索增强生成)
让大模型在回答问题前,先从指定知识库中检索相关内容,再结合检索结果生成答案。例如教师询问报销政策,系统先从学校制度文件中检索相关条款,再由大模型组织答案。
124. 向量数据库(Vector Database)
用于存储和检索向量化后的数据,关注内容之间的语义相似度。例如搜索“学生困难补助”,即使文件中写的是“家庭经济困难学生资助”,系统仍可能找到相关内容。
125. 知识图谱(Knowledge Graph)
通过“实体—关系—实体”的方式组织知识,如“教师→发表→论文”“教师→承担→项目”,适合处理关系明确、需要关联查询和知识推理的数据。
126. 语义层(Semantic Layer)
在底层技术数据与上层业务应用之间建立统一的业务解释,把底层字段、计算规则和业务含义统一起来,让报表、数据分析和AI应用使用同一套业务口径。
127. 数据智能体(Data Agent)
能够理解用户需求,并自动调用数据、分析数据和生成结果的AI应用,代表数据应用从“人找数据”走向“AI帮助人使用数据”。
128. MCP(Model Context Protocol)
连接AI应用与外部数据、工具和服务的开放协议,让不同数据源和工具能够通过相对统一的方式提供给AI应用调用。
129. 智能数据治理(AI-driven Data Governance)
利用AI辅助完成传统数据治理工作,如识别重复数据、发现异常值、匹配数据标准、生成数据描述等,让大量依赖人工的工作更加自动化。
130. 多模态数据集成(Multimodal Data Integration)
对文本、图片、音频、视频、文档等不同类型数据进行统一接入、组织、管理和使用。高校数据集成的对象,正在从“业务数据库”进一步扩展到“全类型数字资源”。
结语:高校数字化竞争,最终是数据能力竞争
高校信息化建设正在经历三个阶段:
从ETL到实时数据,从数据仓库到湖仓一体,从数据治理到AI-ready,从API到MCP——技术一直在变化,但高校数据建设的核心逻辑没有变:
把数据接起来,把标准统一起来,把质量管起来,把服务建起来,最终让数据真正进入业务。
未来高校数字化竞争,比的不会是谁的系统更多,也不会只是“谁先上大模型”。真正拉开差距的,是一所学校能不能把多年积累的数据和知识资源,转化成稳定、可信、可复用的数据能力。
*(本文共梳理130个高校数据集成核心名词,供信息化建设从业者参考。如需转载,请注明出处。)*
 开放时间: